Provedor de IA
Onde no admin: System › Settings › AI provider (
/settings/ai). O interruptor do módulo de IA fica lá e em System › Admin › License & updates (/license), cartão Module.
O que faz
O AI Chat (chat de suporte automático) e o AI Agent (administração de VMs em linguagem natural) não vêm com um modelo integrado. Você escolhe seu próprio provedor: qualquer serviço que ofereça uma chat/completions API compatível com OpenAI — por exemplo, OpenAI, OpenRouter, um gateway LiteLLM ou seu próprio servidor vLLM. O NexCMP armazena o endpoint e a chave de API (criptografados) e os utiliza para todos os recursos de IA. Você paga diretamente ao provedor.
Requisitos
| Item | Requisito |
|---|---|
| Endpoint | Uma URL base compatível com OpenAI (https://api.openai.com/v1, https://ai.example.com/v1). O NexCMP adiciona /chat/completions a uma URL que termina em /v1; para qualquer outra URL, ele adiciona /v1/chat/completions; uma URL que já termina em /chat/completions é usada como está. |
| Modelo | Um modelo compatível com tool (function) calling (chamada de ferramentas). Tanto o AI Chat quanto o Agent dependem dele. |
| Chave de API | Uma chave para esse endpoint. Prefira uma chave com limite de gastos no provedor (por exemplo, uma chave virtual do LiteLLM com um orçamento mensal). |
| Rede | O servidor do painel deve alcançar o endpoint via HTTP(S). Uma URL inserida no formulário só tem permissão para apontar para a Internet nas portas 80, 443, 8080 ou 8443; para usar um endereço interno, salve o provedor primeiro e teste em seguida. |
| Dependências | O módulo AI ativado. Para o Agent, consulte AI Agent. |
Preparar a infraestrutura
Inscreva-se no provedor e crie uma chave de API. Se o provedor for compatível com orçamentos ou limites de taxa, defina um limite mensal.
Anote a URL base e o nome exato do modelo (e, opcionalmente, até quatro modelos de fallback).
Teste-o a partir do servidor do NexCMP antes de inseri-lo:
bashcurl -s https://ai.example.com/v1/chat/completions \ -H "Authorization: Bearer XXXX" -H "Content-Type: application/json" \ -d '{"model":"gpt-4o-mini","messages":[{"role":"user","content":"Reply with one word: OK"}]}'Uma resposta JSON com
choices[0].message.contentsignifica que o endpoint está funcionando.
Conectar no NexCMP
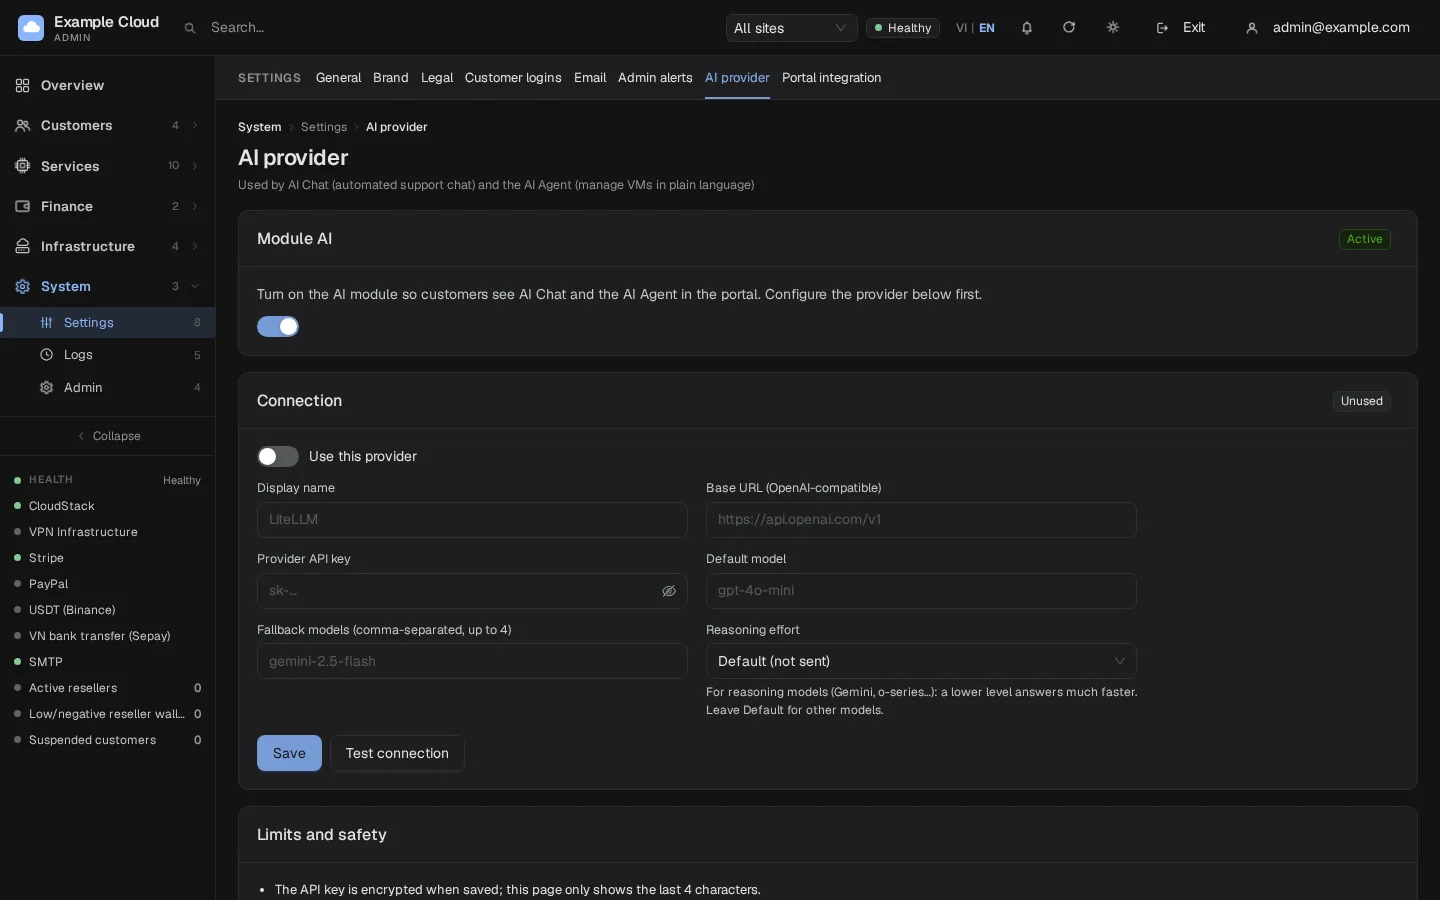
Abra System › Settings › AI provider.
No cartão Module AI, mude o módulo para on (ativado). Até que esteja ativado, os clientes não verão o AI Chat ou o AI Agent no portal. (Você também pode alternar isso em License & updates.)
No cartão Connection, preencha:
Campo Exemplo Notas Usar este provedor on Requer uma URL base, um modelo e uma chave para ser ativado. Nome de exibição LiteLLMAté 60 caracteres. URL base (compatível com OpenAI) https://ai.example.com/v1http://ouhttps://, até 300 caracteres, sem espaços.Chave de API do provedor sk-XXXXArmazenada criptografada; depois, apenas os últimos 4 caracteres são exibidos. Deixe em branco para manter a chave salva. Modelo padrão gpt-4o-miniLetras, dígitos e - _ . / : @.Modelos de fallback gemini-2.5-flashSeparados por vírgula, até 4. Usados quando o modelo padrão falha. Esforço de raciocínio Padrão (não enviado) Minimal,Low,MediumouHigh. Para modelos de raciocínio (Gemini, série o), um nível baixo responde muito mais rápido. Deixe em Padrão para modelos normais.Clique em Save e, em seguida, em Test connection. O teste envia uma pergunta curta e exibe
Connected — <model>, <ms> msou o erro retornado pelo provedor.
O que o salvamento faz
- As configurações do provedor são salvas como uma única entrada de configuração e a chave é criptografada com AES-256-GCM, vinculada a esta finalidade, usando a chave mestra da instalação.
- As configurações de suporte Primary model e Fallback model (usadas pelo AI Chat) são definidas automaticamente para o seu modelo padrão e primeiro modelo de fallback.
- A alteração é registrada no log de auditoria (endpoint, modelo, se a chave foi alterada — nunca a chave).
Verificar
- Test connection fica verde.
- Faça login no portal como um cliente de teste: o menu agora oferece AI Chat (ou a bolha de chat) e AI Agent.
- Pergunte ao AI Chat "Qual é o meu saldo?". Uma resposta que informe o seu saldo real mostra que o provedor lida com chamadas de ferramentas corretamente.
Limites e notas
- Um único provedor. O NexCMP usa um único provedor configurado para o Chat, o Agent e a investigação de tickets. Os modelos de fallback oferecem resiliência dentro desse provedor.
- Segurança da chave. A chave salva é enviada apenas para o endpoint salvo. Se você alterar a URL base, deverá digitar a chave novamente antes de testar.
- Limites por cliente. O AI Chat é apenas para clientes autenticados, com limites de mensagens por minuto e por chat. O Agente tem um limite diário de chamadas por conta. Veja AI Chat e AI Agent.
- Privacidade. As perguntas dos clientes e os dados que a IA lê para esse cliente (somente leitura) são enviados ao seu provedores. Informe isso na sua política de privacidade.
- Controle de custos. O NexCMP não faz a medição de custos da IA; utilize os recursos de orçamento do provedor.
- O módulo pode ser desativado a qualquer momento: os itens de menu da IA desaparecem e as rotas da IA retornam 404
module_disabled. Algumas tarefas em segundo plano do AI Chat (investigação de tickets, respostas atrasadas) aplicam a alteração na próxima reinicialização do painel.
Resolução de problemas
| Sintoma | Causa | Correção |
|---|---|---|
base_url must be an http(s) URL | Esquema ausente ou espaços | Use https://host/v1. |
api_key is required to enable the provider | Nenhuma chave armazenada | Insira a chave e salve. |
base_url and model are required to enable the provider | Campo vazio | Preencha ambos. |
| "Base URL bloqueada: apenas http(s) público, portas 80/443/8080/8443" | Testando um endereço interno não salvo ou outra porta | Salve o provedor primeiro e depois teste. |
api_key is required (enter the key again when you change the endpoint) | A Base URL difere da salva | Redigite a chave. |
model: letters, digits and - _ . / : @ | Caractere inválido | Use o ID de modelo exato do provedor. |
fallback_models: up to 4 model names | Muitos itens | Mantenha quatro ou menos. |
| O teste falha com 401 | Wrong key | Verifique a chave e o endpoint. |
| O teste falha com 404 ou "model not found" | Caminho ou modelo incorreto | Verifique a URL base (/v1) e o ID do modelo. |
Too many tests — wait a minute (429) | Mais de 10 testes por minuto | Aguarde. |
| O portal ainda não exibe o menu de IA | Módulo desativado ou provedor não está "in use" | Ative o módulo e habilite o provedor. |